Sprechertrennung
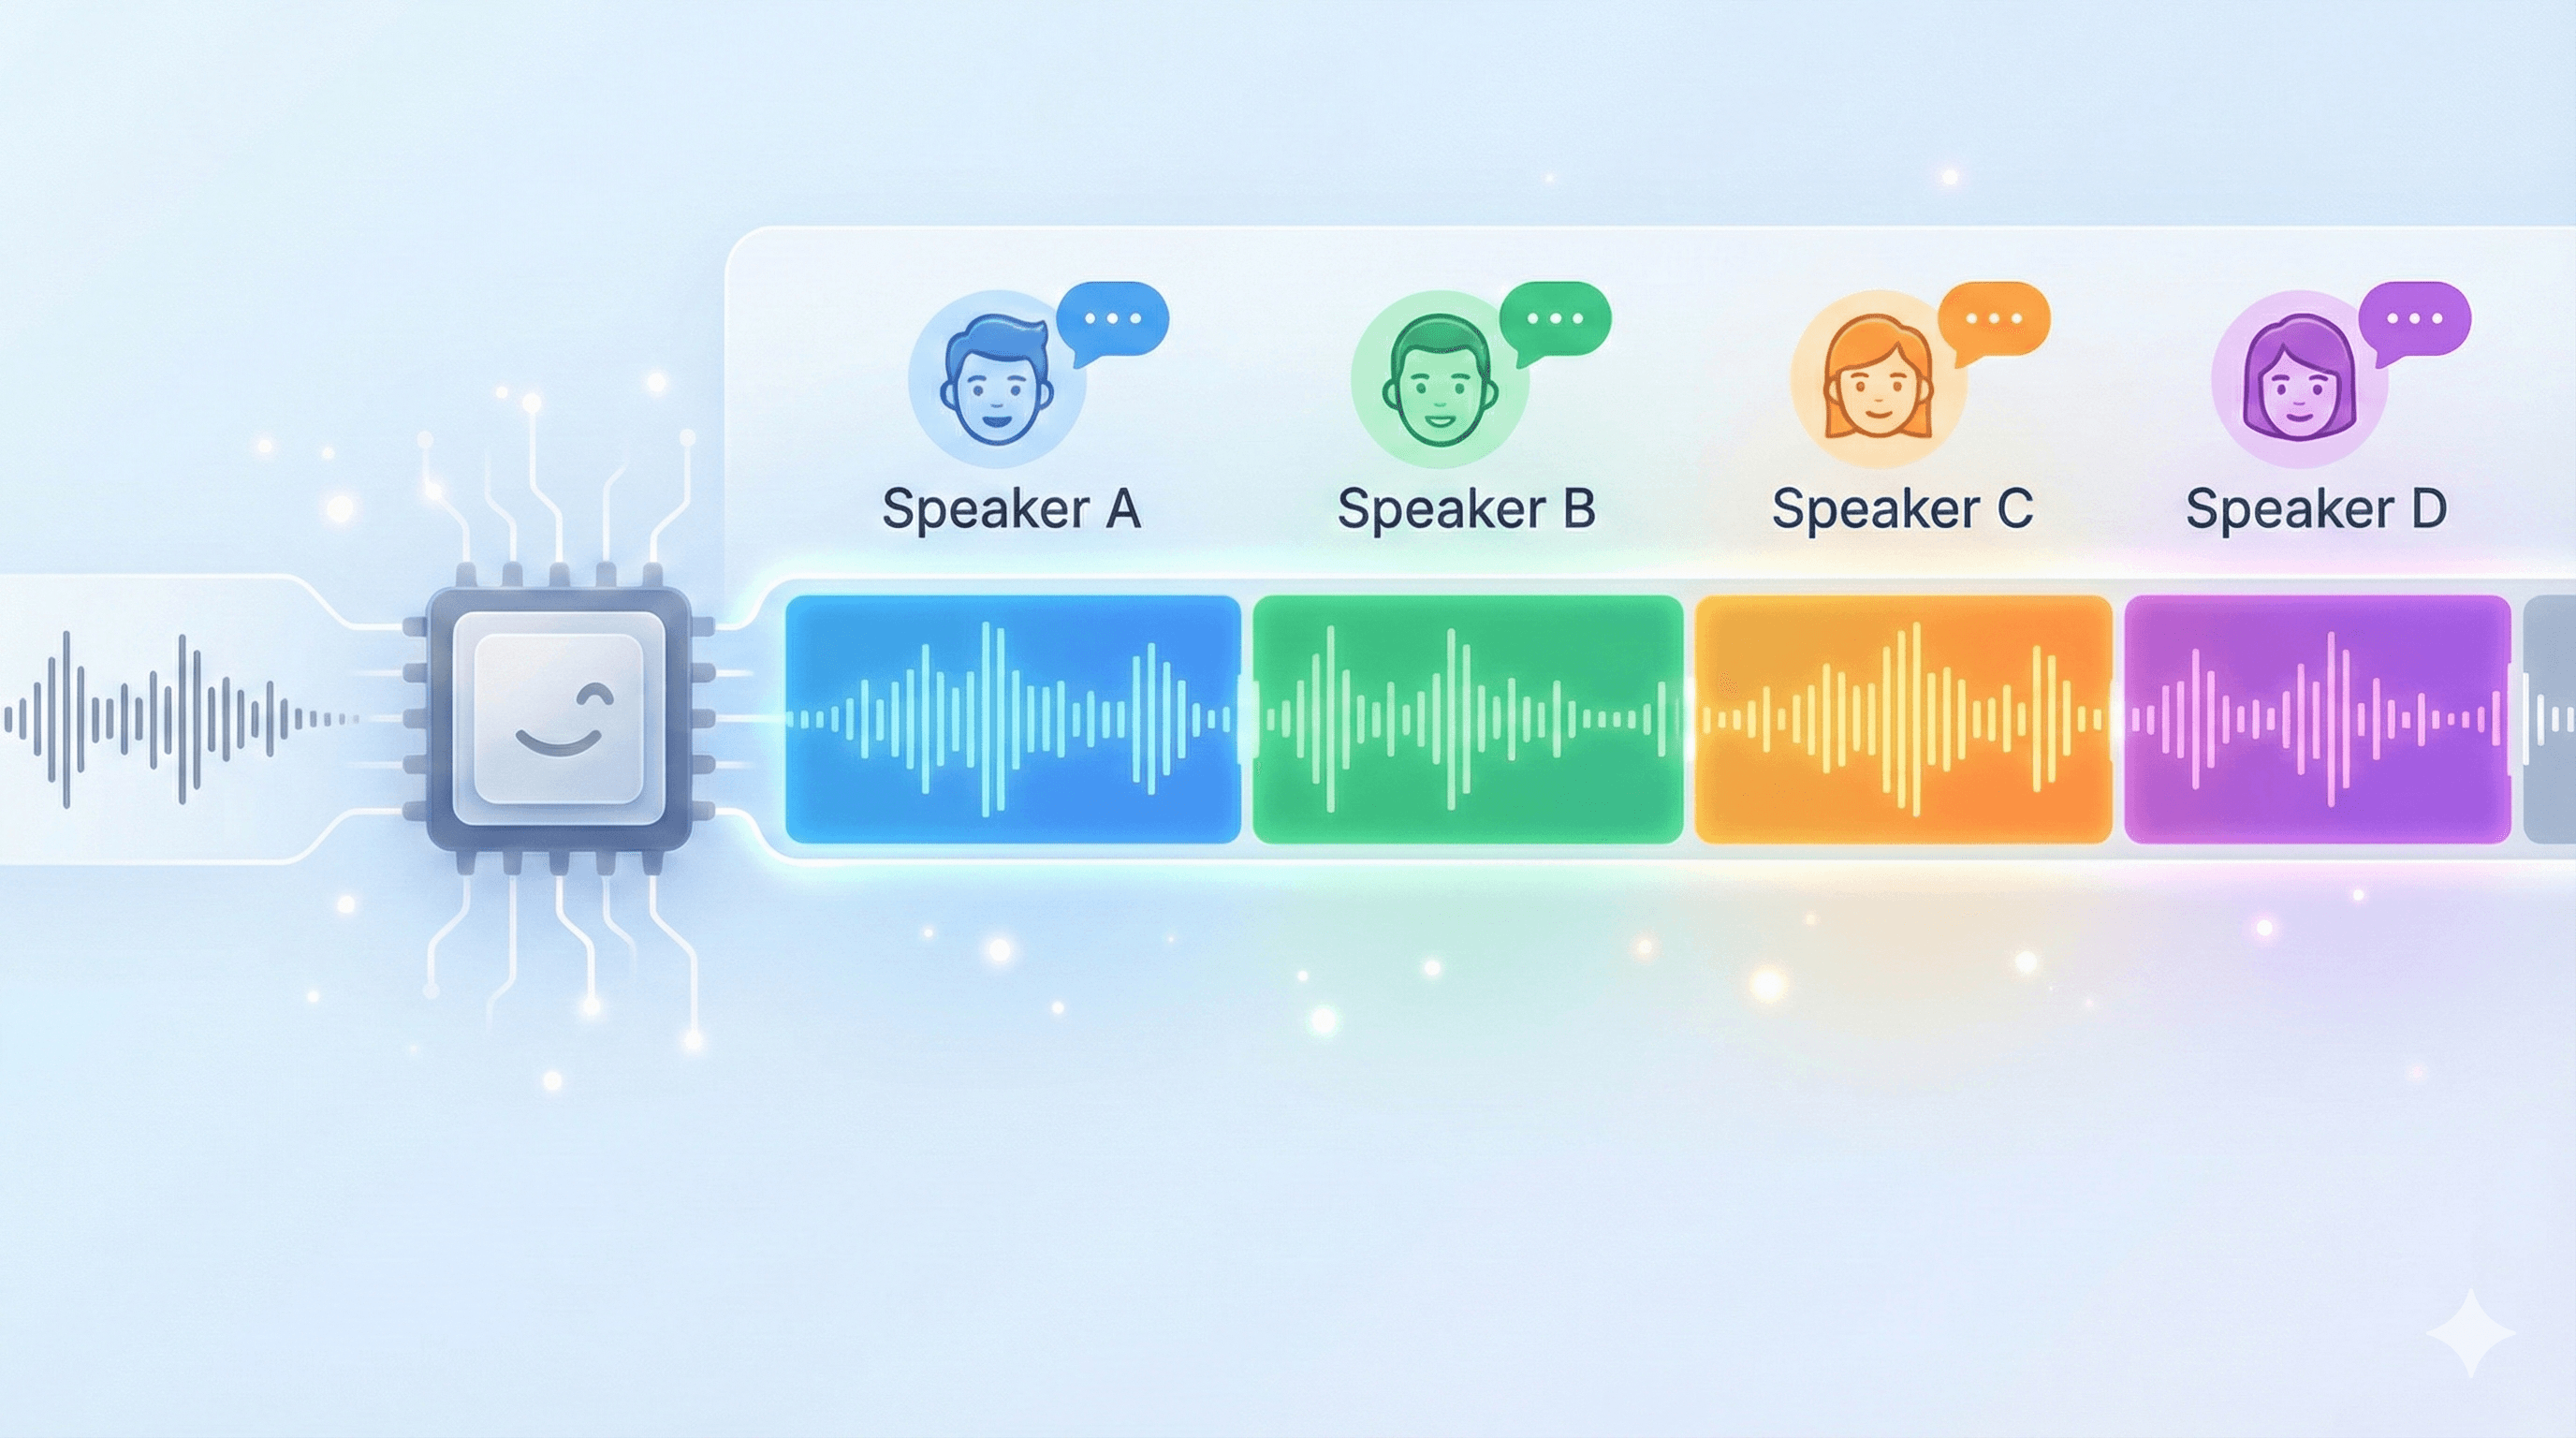
Mach Aufnahmen mit mehreren Personen nutzbar, indem Sprache in Segmente mit Sprecherlabels aufgeteilt wird. Entwickelt für Meetings, Interviews, Panels und Podcasts, erhöht die Diarisierung die Klarheit und reduziert den Aufwand, manuell zuzuordnen, wer was gesagt hat. Eine bearbeitbare Zeitleiste ermöglicht schnelle Korrekturen, und die daraus entstehende Struktur verbessert nachgelagerte Aufgaben wie Dubbing, Untertitelung und präzise Zusammenfassungen.
Wichtige Funktionen
- Zuverlässige Sprechertrennung: Gruppiert Sprache nach Sprecher für klare „Wer hat was gesagt?“-Transkripte.
- Bearbeitbare Sprecher-Zeitleiste: Führe Segmente zusammen oder teile sie auf, um Korrekturen schnell vorzunehmen.
- Für echte Gespräche gemacht: Geht mit Unterbrechungen und schnellen Wechseln besser um als einfache Tools.
- Bessere Basis für Dubbing und Untertitel: Klare Sprecherwechsel verbessern Mehrsprecher-Dubbing und Untertitelgenauigkeit.
Ähnliche Produkte
Das erstellst du damit
Teams, die Meeting-Aufnahmen nutzbar machen
Verwandle ein unübersichtliches Gespräch mit mehreren Sprechern in ein beschriftetes Transkript, um genau zu sehen, wer was gesagt hat – ohne das Audio selbst durchzuhören.
Journalisten, die Interviews transkribieren
Trenne deine Fragen automatisch von den Antworten jeder Quelle, sodass sich lange Interviews viel schneller zitieren, prüfen und ausformulieren lassen.
Podcaster, die Shownotes erstellen
Erhalte eine sprecherweise Zeitleiste von Hosts und Gästen, damit Kapitelmarken, Zitate und präzise Shownotes in Minuten statt Stunden entstehen.
Forschende, die Panels und Fokusgruppen auswerten
Ordne jede Wortmeldung dem richtigen Teilnehmer zu, selbst bei überlappenden Gesprächen, und gib deiner qualitativen Analyse eine saubere Struktur pro Sprecher.
So wird es funktionieren
- 1
Füge deine Mehrsprecher-Aufnahme hinzu
Bring ein Meeting, Interview, Panel oder einen Podcast mit. Das Tool ist für echte Gespräche mit Unterbrechungen und schnellem Hin und Her ausgelegt.
- 2
Sprecher werden getrennt und beschriftet
Die Sprache wird nach Sprecher gruppiert – zu einem klaren „Wer sagt was“-Transkript, bei dem jeder Redebeitrag auf einer prüfbaren Zeitleiste liegt.
- 3
Korrigiere und exportiere das Ergebnis
Führe Segmente auf der bearbeitbaren Zeitleiste zusammen oder teile sie, um Verwechslungen zu beheben, und exportiere eine Struktur, die auch Synchronisation und Untertitel verbessert.
Häufige Fragen
- Welche Audioformate unterstützt die Sprechertrennung?
- MP3, WAV, M4A, AAC, OGG und FLAC – die Formate, in denen Meeting-, Interview- und Podcast-Aufnahmen üblicherweise vorliegen.
- Wie viele Sprecher kann das Tool unterscheiden?
- Das Tool ist für echte Gespräche mit mehreren Personen ausgelegt – Meetings, Interviews, Panels und Podcasts – nicht nur für zwei Personen, und soll Unterbrechungen und schnelles Hin und Her bewältigen.
- Kann ich einen falsch zugeordneten Sprecher korrigieren?
- Ja. Benenne Sprecher um, ordne einen Redebeitrag einem anderen Sprecher zu oder trenne ihn auf einen neuen Sprecher ab, wenn zwei Personen zusammengefasst wurden – deine Korrekturen werden mit dem Transkript gespeichert.
- Ist Sprechertrennung dasselbe wie Transkription?
- Nicht ganz. Transkription wandelt Sprache in Text um; die Sprechertrennung ermittelt, wer wann gesprochen hat, und beschriftet jeden Redebeitrag. Zusammen ergeben sie ein klares, sprecherzugeordnetes Transkript.
- Kann ich das Transkript exportieren?
- Ja – lade es als TXT, SRT oder VTT herunter, damit dasselbe sprecherbeschriftete Ergebnis für Dokumente und Untertitel funktioniert.