Rozpoznawanie mówców
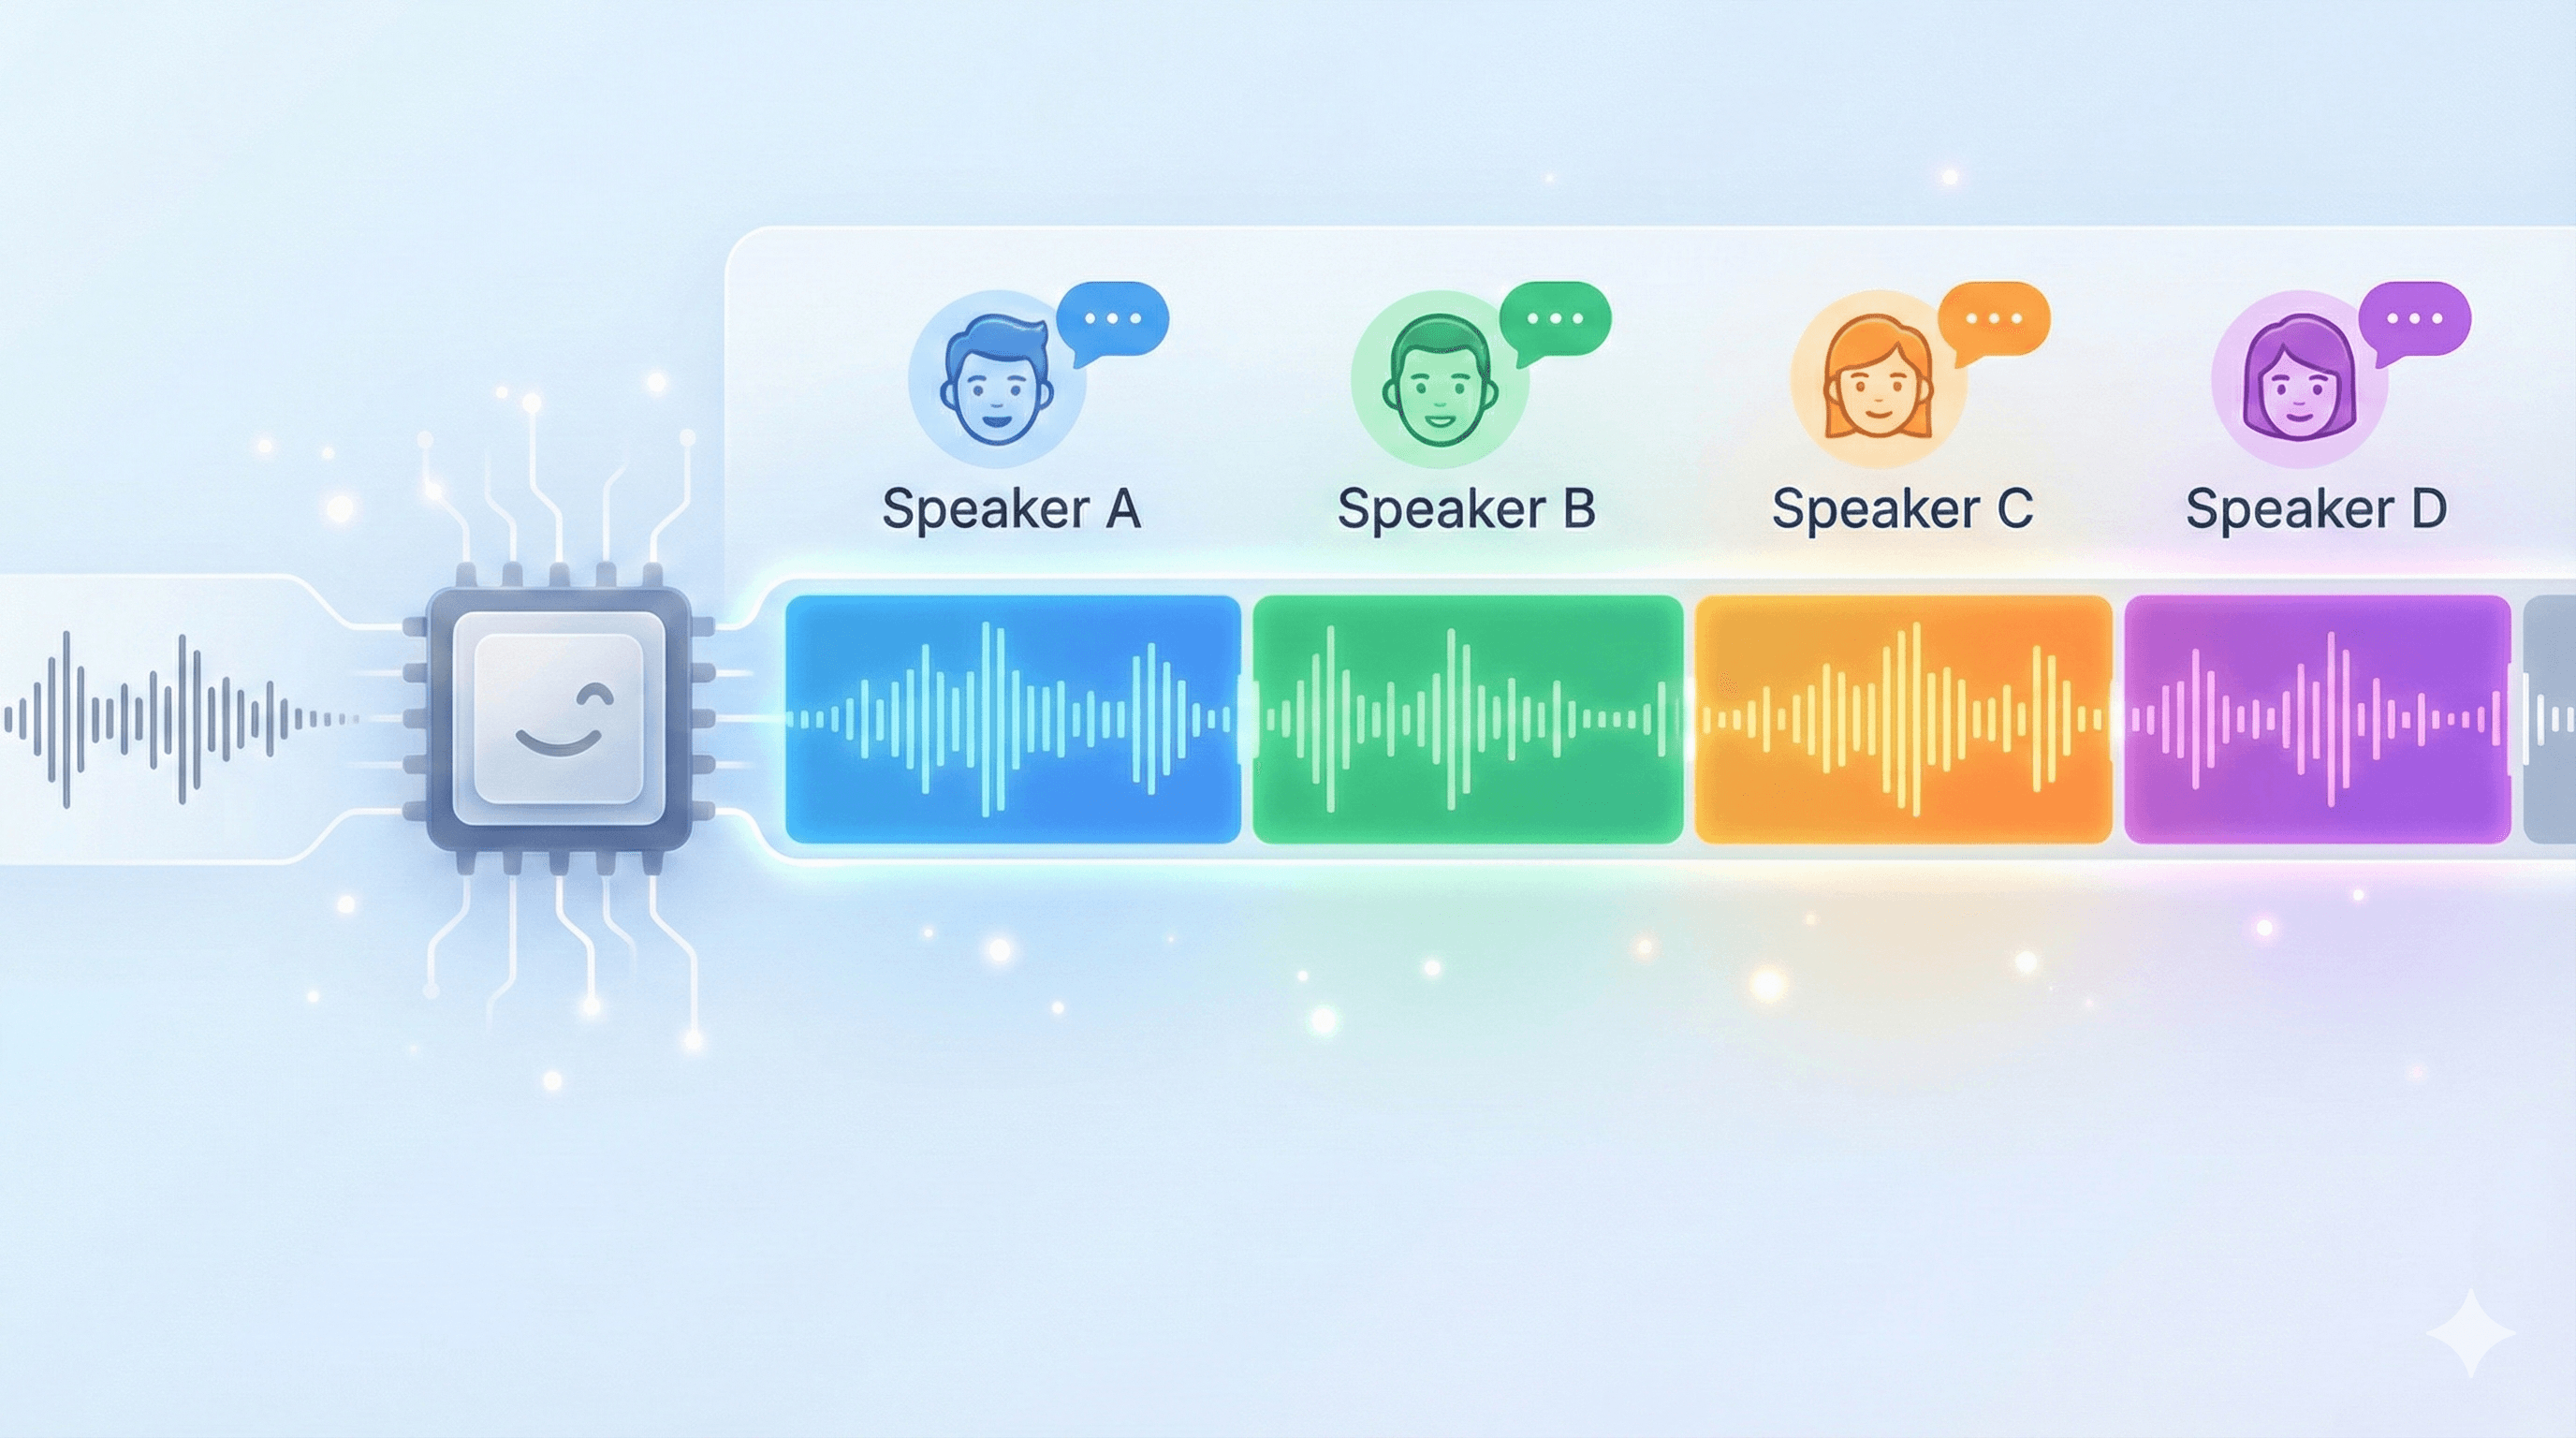
Spraw, by nagrania z udziałem wielu osób były naprawdę użyteczne, dzieląc wypowiedzi na segmenty przypisane do konkretnych mówców. Narzędzie zaprojektowano z myślą o spotkaniach, wywiadach, panelach i podcastach — poprawia czytelność i skraca czas ręcznego ustalania, kto co powiedział. Edytowalna oś czasu pozwala szybko wprowadzać poprawki, a uzyskana struktura usprawnia dalsze etapy, takie jak dubbing, napisy i dokładne podsumowania.
Kluczowe funkcje
- Niezawodne rozdzielanie mówców: Grupuje wypowiedzi według mówcy dla czytelnych transkryptów „kto co powiedział”.
- Edytowalna oś czasu mówców: Łącz/dziel segmenty mówców dla szybkiej korekty, gdy potrzeba.
- Zaprojektowane dla prawdziwych rozmów: Lepiej radzi sobie z przerywaniem i szybkim dialogiem niż podstawowe narzędzia.
- Lepszy dubbing/napisy: Poprawia dubbing wielomówcowy i dokładność napisów dzięki klarownym zmianom mówcy.
Podobne produkty
Co stworzysz
Zespoły porządkujące nagrania ze spotkań
Zamień chaotyczną rozmowę wielu osób w oznaczony zapis, aby dokładnie widzieć, kto co powiedział, bez ręcznego przesłuchiwania nagrania.
Dziennikarze transkrybujący wywiady
Automatycznie oddziel swoje pytania od odpowiedzi każdego rozmówcy, dzięki czemu długie wywiady szybciej zacytujesz, zweryfikujesz i opracujesz.
Podcasterzy przygotowujący notatki do odcinka
Uzyskaj oś czasu z podziałem na wypowiedzi gospodarzy i gości, aby tworzyć znaczniki rozdziałów, cytaty i dokładne notatki w minuty, a nie godziny.
Badacze analizujący panele i grupy fokusowe
Przypisz każdą wypowiedź właściwemu uczestnikowi, nawet gdy głosy się nakładają, i nadaj analizie jakościowej czytelną strukturę z podziałem na mówców.
Jak to będzie działać
- 1
Dodaj nagranie z wieloma mówcami
Wgraj spotkanie, wywiad, panel lub podcast. Narzędzie jest przygotowane na prawdziwe rozmowy — z przerywaniem i szybką wymianą zdań.
- 2
Mówcy zostają rozdzieleni i oznaczeni
Wypowiedzi są grupowane według mówcy w czytelny zapis „kto co powiedział”, a każda tura trafia na oś czasu, którą możesz przejrzeć.
- 3
Popraw i wyeksportuj wynik
Scalaj lub dziel segmenty na edytowalnej osi czasu, aby usuwać pomyłki, i eksportuj strukturę, która poprawia też późniejszy dubbing i napisy.
Najczęstsze pytania
- Jakie formaty audio obsługuje diaryzacja mówców?
- MP3, WAV, M4A, AAC, OGG i FLAC — formaty, w których zwykle trafiają do nas nagrania ze spotkań, wywiadów i podcastów.
- Ilu mówców potrafi rozróżnić?
- Narzędzie jest zaprojektowane do prawdziwych rozmów z udziałem wielu osób — spotkań, wywiadów, paneli i podcastów — a nie tylko dwóch osób, i ma radzić sobie z przerywaniem oraz szybką wymianą zdań.
- Czy mogę poprawić błędnie oznaczonego mówcę?
- Tak. Zmień nazwę mówcy, przypisz wypowiedź do innego mówcy albo wydziel ją do nowego, gdy model połączył dwie osoby — poprawki zapisują się razem z transkrypcją.
- Czy diaryzacja to to samo co transkrypcja?
- Niezupełnie. Transkrypcja zamienia mowę w tekst; diaryzacja ustala, kto i kiedy mówił, oraz oznacza każdą turę. Razem dają czytelny zapis przypisany do poszczególnych mówców.
- Czy mogę wyeksportować transkrypcję?
- Tak — pobierz ją jako TXT, SRT lub VTT, dzięki czemu ten sam wynik z etykietami mówców posłuży do dokumentów i napisów.